AI-modellen worden goedkoper. Waarom wordt development met AI dan duurder?
Bij de grotere organisaties waar ik kom zie ik de kosten die development teams maken voor AI de pan uit rijzen. Developers zijn steeds sneller door hun maandbudget van GitHub Copilot-credits heen. Enkele dagen na de start van de maand zie ik ze om meer credits vragen. Tegelijkertijd wordt een vast niveau van AI-capability steeds goedkoper: het Opus-niveau van nu is over een paar maanden goedkoper.
In deze post leg ik uit hoe het kan dat we steeds duurder uit zijn, terwijl AI kennelijk ook steeds goedkoper wordt. Ik begin met de redenen waarom we steeds meer geld kwijt zijn aan AI.
I Waarom het tokenverbruik stijgt
Vier ontwikkelingen werken tegelijk, en ze versterken elkaar. Ze gaan allemaal over hetzelfde: per gedelegeerde taak gaan er meer tokens door het model.
01
Agents kunnen steeds langer autonoom werken
METR meet de taaklengte als de tijd die een menselijke expert nodig zou hebben voor dezelfde taak. Die lengte groeit exponentieel.1
In 2022 waren chats met een model kort en reactief: prompt in, antwoord uit. Tegenwoordig kunnen de frontier LLMs veel meer rekenkracht aan één taak besteden. Coding agents bouwen daar nog iteratieve loops omheen. Daardoor kunnen agents steeds complexere taken zelfstandig uitvoeren.
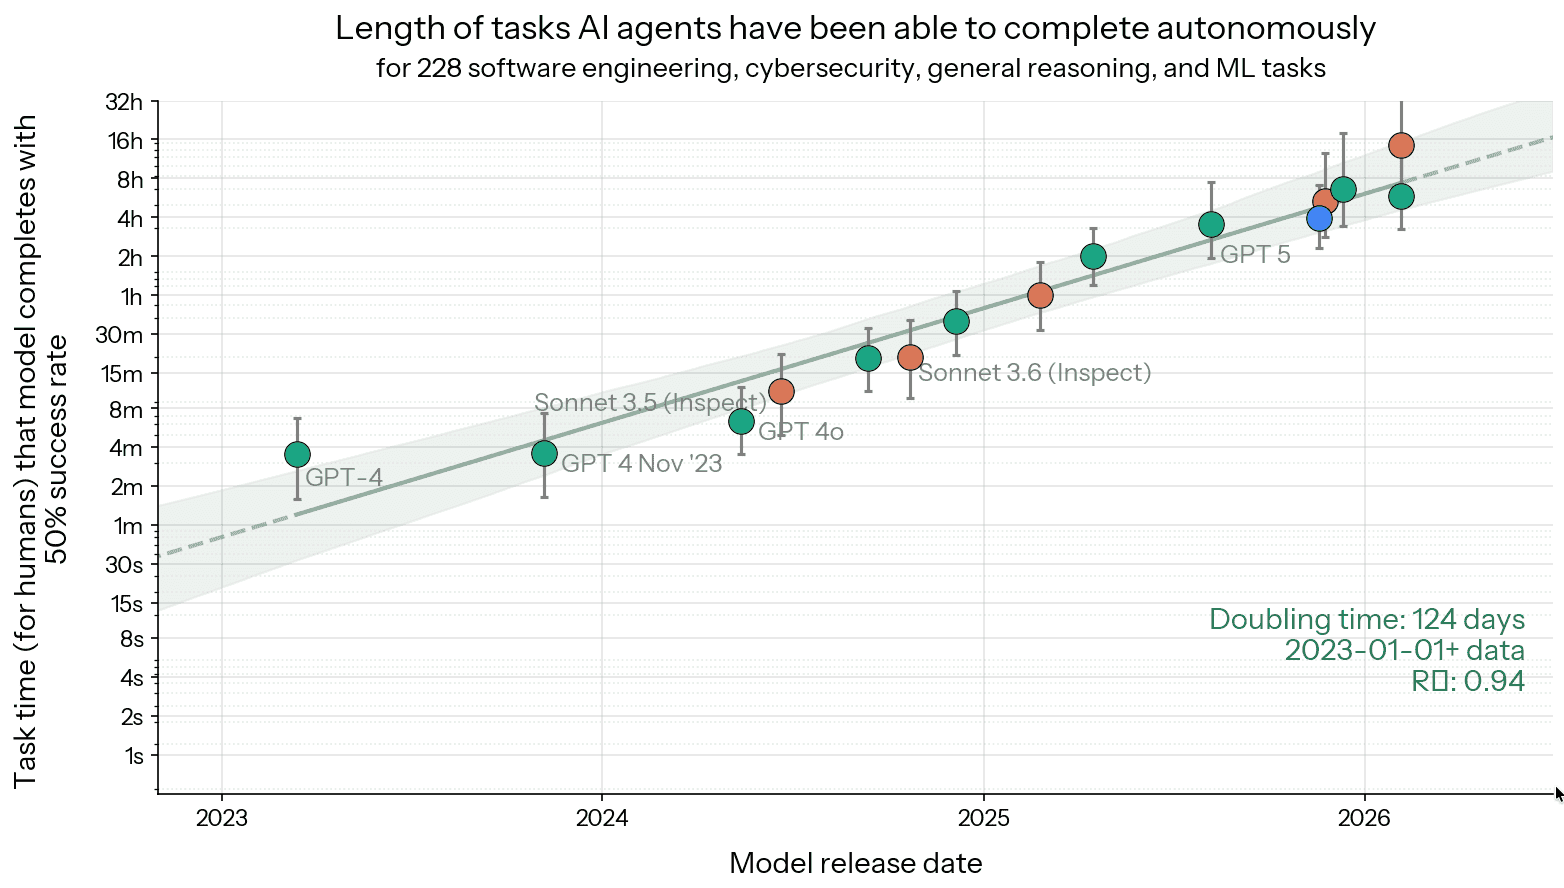
De taaklengte verdubbelt elke 124 dagen. METR, Task-Completion Time Horizons of Frontier AI Models.
Deze trend zorgt ervoor dat agents steeds meer nuttige taken op kunnen pakken. En langere taken betekenen meer LLM-requests, een steeds grotere context en meer tool calls. Met andere woorden: er worden meer tokens gebruikt.
02
Reasoningmodellen besteden meer compute
Eind 2024 werden de eerste mainstream reasoningmodellen gelanceerd (OpenAI o1 en DeepSeek R1 Lite). Deze LLMs besteden extra rekenkracht aan hun taak. Volgens onderzoek van Epoch AI2 groeide de outputlengte van reasoningmodellen ongeveer 5× per jaar, tegenover 2,2× bij non-reasoningmodellen. Daarnaast gebruiken reasoningmodellen gemiddeld ongeveer 8× zoveel outputtokens. De modellen zijn slimmer, maar je betaalt voor de extra tokens.
03
Agentic coding verbruikt flink meer tokens
Bai et al. vergeleken agentic coding met gewone code-chat en code-reasoning op SWE-bench Verified.3
Een van de redenen waardoor agents langer zelfstandig kunnen werken zijn de harnesses zoals Claude Code en Codex. Een coding agent werkt in een loop: repository onderzoeken, code lezen, redeneren, bestanden aanpassen, tests uitvoeren, resultaten inspecteren, opnieuw redeneren. Bij iedere ronde groeit de context die opnieuw door het model verwerkt moet worden.
Bai et al. vonden in hun SWE-bench Verified-experiment dat agentic coding ongeveer 1.000× zoveel tokens verbruikte als gewone code-chat en code-reasoning. Vooral het steeds opnieuw verwerken van input, context en eerdere state bleek een belangrijke kostenpost.
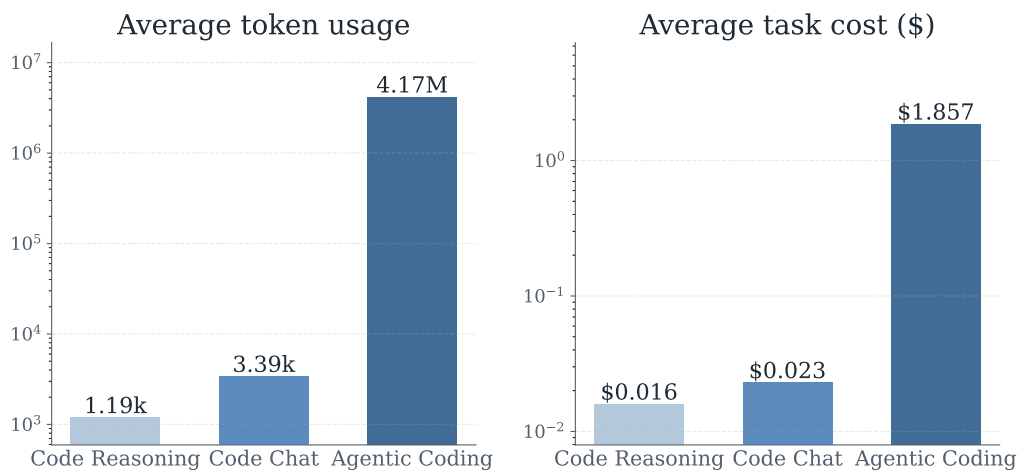
4,17 miljoen tokens en $1,86 per taak, tegenover 3,39k tokens en $0,023 voor code chat.
04
Steeds meer development teams gebruiken AI
Doordat agentic coding steeds meer taken kan uitvoeren, kun je er als ontwikkelaar bijna niet meer omheen. JetBrains4 deed onderzoek: 90% van meer dan 15.000 professionele developers gebruikte AI coding agents minstens wekelijks op het werk, 68% dagelijks. Vooral Claude Code heeft sinds januari 2026 enorm veel terrein gewonnen, van 18% naar 39%.
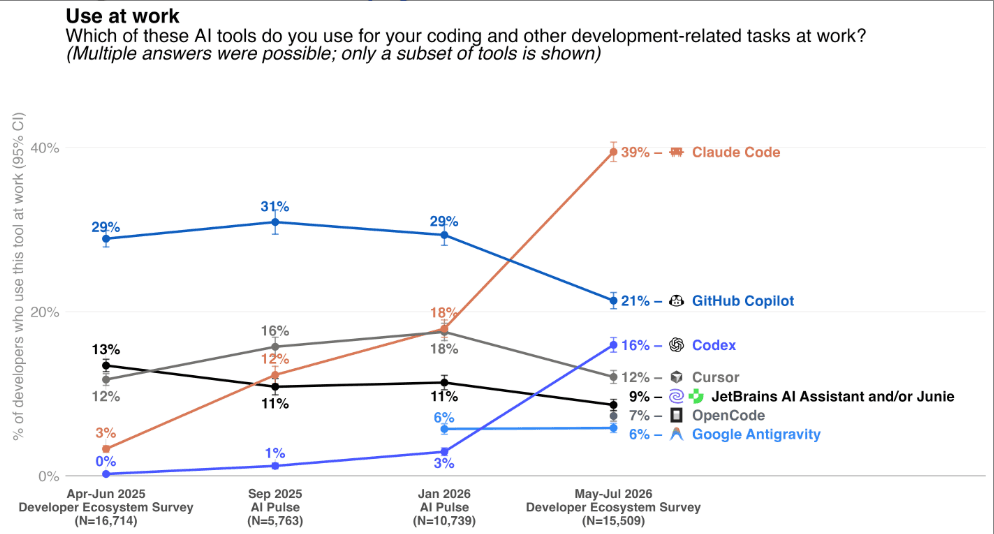
Claude Code klimt naar 39%, terwijl GitHub Copilot zakt van 29% naar 21%. JetBrains, AI Coding Agents: Adoption Trends.
II Intelligentie wordt wél goedkoper, maar we kopen steeds de duurste
De dalende prijs van intelligentie wordt deels tenietgedaan doordat we steeds de nieuwste frontier-modellen gebruiken.
05
Een vast capabilityniveau daalt snel in prijs
Ik zei in de inleiding dat intelligentie ook steeds goedkoper wordt. Hoe zit dat dan? Een vast niveau van AI-capability wordt snel goedkoper. Als voorbeeld: het model Sonnet 55 kwam een maand na Opus 4.8 uit, maar kwam op verschillende coding- en agentic benchmarks dicht in de buurt van Opus 4.8, terwijl de tokenprijzen 60% lager lagen.
06
Developers blijven toch de frontier kiezen
Ondanks dat goedkopere modellen slimmer worden, blijven developers de frontier gebruiken. Ik zie het bij mezelf. Coding doe ik met de frontier-modellen Fable, Opus en Astra. Sonnet gebruik ik nooit, om twee redenen: ik heb voldoende capaciteit voor de slimmere modellen, en ik ben bang dat minder intelligente AI tot slechtere resultaten leidt.
07
AI wordt niet duurder, we gebruiken er meer van
Zodra een nieuwe frontier beschikbaar komt, gebruiken we die voor moeilijkere taken, langere reasoning en complexere agents.
De keten loopt zo:
- Betere modellen kunnen langere taken aan.
- Langere taken vragen meer reasoning.
- Coding harnesses zetten dat reasoning in iteratieve agent-loops.
- Iedere loop verwerkt opnieuw code, context en tool-output.
- Daardoor groeit het tokenverbruik, en daarmee de kosten per gedelegeerde taak.
De rekening is het product van vier factoren. Eén daalt, drie stijgen harder:
De prijs per eenheid intelligentie is de enige knop die de goede kant op draait.
III GitHub Copilot: de kosten rijzen de pan uit
Voor mijn persoonlijke projecten gebruik ik Claude Code en Codex. Met die abonnementen heb ik zoveel tokens tot mijn beschikking dat ik praktisch nooit tegen limieten aanloop. Ik denk dat velen dit herkennen. Bij grotere organisaties ligt dat anders.
08
Waarom grote organisaties voor Copilot kiezen
Zij kiezen vaak voor GitHub Copilot omdat het past binnen bestaande Microsoft-contracten, centrale governance, model policies en data-residency-eisen. De keuze gaat daarmee minder over vertrouwen in een Amerikaanse leverancier en meer over controle, contracten en compliance. Microsoft is uiteraard ook Amerikaans.
Binnen GitHub Enterprise Cloud met data residency kunnen bedrijven wel afdwingen dat prompts, code, responses, logs en telemetry binnen de EU blijven. Dat komt wel met een meerprijs van 10%. Een request dat normaal 100 credits kost, kost met EU data residency dus 110 credits. Compliance maakt de AI-rekening dus hoger.
09
De pricing ging van vast naar variabel
Bij Enterprise-accounts krijgt elke seat 3.900 credits, die gedeeld worden over het bedrijf. Extra AI Credits kosten $0,01 per credit.
Helaas voor de BV Nederland heeft Copilot de afgelopen tijd flink gesleuteld aan de pricing. En die pricing, in combinatie met het verhaal hierboven, zorgt voor een enorme stijging van de kosten voor AI-gebruik door development teams.
| Jaar | Wat een bedrijf betaalt |
|---|---|
| 2022 | $19 per developer, all-in |
| 2025 | Basisprijs plus premium requests |
| 2026 | Variabel, afhankelijk van model en verbruikte tokens |
IV Wat kun je eraan doen
Puur vanuit de kosten bekeken is de eenvoudigste oplossing overstappen naar Claude Code of Codex. In mijn ervaring zijn die coding harnesses beter dan Copilot en je krijgt ruime tokenlimieten. Maar dan lever je wel in op verschillende requirements van de compliance-afdeling. Ik zie dit niet zo snel gebeuren bij de meeste bedrijven waar ik rondloop. Ik zie drie andere oplossingen.
10
Copilot beter benutten: niet alles hoeft naar de frontier
Niet elke taak hoeft door een frontier LLM te worden uitgevoerd. Goedkopere modellen kunnen subtaken in het codingproces oppakken, bijvoorbeeld exploratie, documentatie en het schrijven van tests. Routeer alleen complexe problemen naar de frontier LLMs.
Het kan handmatig, maar beter is automatische modelrouting. Laat tooling op basis van taakcomplexiteit bepalen welk model nodig is. Hiermee pak je het voordeel dat ik hierboven beschreef: een vast capabilityniveau wordt steeds goedkoper.
Handmatig modellen kiezen per taak vergt kennis en discipline bij gebruikers. Ze moeten weten wanneer een goedkoper model goed genoeg is, en tooling en werkprocessen moeten zo ingericht zijn dat goedkopere modellen minder ruimte krijgen om fouten te maken. In mijn ervaring vraagt dit om training, duidelijke werkafspraken en goede tooling.
11
Gebruik betere tooling met inference binnen de EU
De open-source harness OpenCode ligt qua features dicht bij Codex en Claude Code, en is in mijn ervaring een interessant alternatief.
Je hoeft niet per se Copilot te gebruiken om aan Europese data-eisen te voldoen. Partijen als Scaleway bieden inference op modellen binnen de EU, terwijl gateways zoals Requesty modelverkeer naar Europese deployments kunnen routeren. Daarmee kun je bijvoorbeeld een goede coding harness combineren met een goedkoper near-frontiermodel, en zelf bepalen wanneer je opschaalt naar een duurder model.
Dit lijkt voor de meeste bedrijven een interessante middenweg: wel centrale governance en verwerking binnen de EU, maar geen vendor lock-in bij GitHub, waar je premium pricing betaalt.
12
Host modellen zelf als het volume groot genoeg is
Bij voldoende schaal kan dedicated of self-hosted inference aantrekkelijk worden. Je krijgt maximale controle over data, modellen en kosten, maar neemt ook GPU-capaciteit, scaling, monitoring en operations op je.
Self-hosting is dus niet automatisch goedkoper. Bij lage utilisation betaal je vooral voor stilstaande GPU's. Pas bij een groot en voorspelbaar inferencevolume wordt het interessant om managed inference af te zetten tegen dedicated of self-managed GPU-capaciteit.
V Kijk niet alleen naar de kosten, ook naar de opbrengsten
Het doel moet niet zijn om de AI-rekening zo laag mogelijk te krijgen. Als een developer €500 aan AI-inference verbruikt maar daarmee voor €5.000 extra engineering output levert, heb je een uitstekende deal.
13
De vraag verandert van prijs per developer naar output per euro
De interessante vergelijking is niet meer "wat kost Copilot per developer?", maar "hoeveel engineering output krijgen we per euro AI-inference?". Alle trends uit dit artikel werken namelijk tegelijk:
- Meer developers gebruiken AI.
- Iedere developer delegeert meer werk.
- Iedere taak kan meer inference en tokens verbruiken.
- Usage-based pricing maakt dat verbruik direct zichtbaar op de rekening.
De organisaties die dit goed aanpakken zullen waarschijnlijk niet de laagste AI-rekening hebben. Ze zullen vooral veel beter weten welke taken frontier-intelligentie verdienen en welke niet.
Bronnen
-
METR, Task-Completion Time Horizons of Frontier AI Models, mei 2026. ↩
-
Epoch AI, LLM responses to benchmark questions are getting longer over time, april 2025. ↩
-
Bai et al., How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks, april 2026. ↩
-
JetBrains, AI Coding Agents: Adoption Trends, augustus 2026. ↩
-
Anthropic, Introducing Sonnet 5, juni 2026. ↩